아티클
다양한 읽을거리를 확인해 보세요.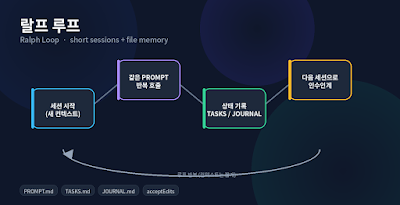
[아티클 02] 랄프 루프, 루프 엔지니어링이 필요할 때
📅 2026년 9월 21일 · 👁 21
[아티클 02] 랄프 루프, , 루프 엔지니어링이 필요할 때만화 심슨 가족에 나오는 랄프(Ralph)는 똑똑하지는 않지만 엉뚱하고 귀여운 친구입니다. 무엇보다도, 한 가지를 끈질기게 반복하는 캐릭터입니다. 랄프 루프(Ralph loop)라는 이름은 제프리 헌틀리(Geoffrey Huntley)라는 엔지니어가 이 기법을 소개하면서 붙인 이름입니다.랄프 루프의 아이디어는 이렇습니다. 클로드 코드 같은 CLI를 비대화형 모드로 계속 반복 호출합니다. 심지어 매번 같은 프롬프트를 사용합니다. 매 호출마다 새로운 세션이 시작됩니다. 세션이 종료될 때 작업 상태를 파일에 기록해 다음 세션으로 넘깁니다. 지금까지 무엇을 했고 다음에 무엇을 할지를 파일로 남기는 방식입니다. 이 방법은 세션을 짧게 유지하므로, 모델의 컨텍스트가 커져서 성능이 하락하는 현상을 줄입니다. 세션을 짧게 유지하고, 파일을 메모리처럼 사용합니다. 에이전트 입장에서는 기억상실증에 걸린 직원이 출근할 때마다 인수인계 문서를 읽는 것과 같은 상태이긴 합니다.루프 자체의 구현은 정말 단순해서 몇 줄로 끝납니다.위 예시는 루프의 최소 형태를 보여주기 위한 무한 루프입니다. 실제로는 TASKS.md에 완료 표식을 남기게 하고, 셸 스크립트가 그 표식을 검사해 종료하도록 만드는 편이 안전합니다.--permission-mode acceptEdits는 주로 파일 작성과 수정, 그리고 작업 디렉터리 안의 일반적인 파일 시스템 명령을 자동 승인하는 모드입니다. 테스트 실행이나 uv, git, 서버 기동처럼 셸을 거치는 작업은 Bash 권한과 별도 허가 규칙의 영향을 받습니다. 그래서 비대화형 루프에서는 --allowedTools Bash처럼 넓게 주기보다, 가능하면 Bash(uv run pytest*), Bash(git status*)처럼 필요한 명령만 좁혀 허용하는 편이 안전합니다.PROMPT.md에는 임무와 작업 절차를 적습니다. 한 세션에 한 항목만 처리할 것, docs/TASKS.md의 체크박스로 진행 상태를 관리할 것, 막히면 해당 항목에 BLOCKED: {이유}를 적고 종료할 것 같은 규칙이 핵심입니다. TASKS.md는 세션 사이를 잇는 연속성이고, JOURNAL.md는 루프가 무슨 작업을 했는지 나중에 확인하기 위한 기록입니다.예를 들어 uv run pytest가 계속 실패하는데도 클로드가 같은 수정을 반복한다면, TASKS.md에 해당 항목을 BLOCKED로 표시하고 다음 항목으로 넘어가게 합니다. 세 번 이상 같은 실패 로그가 반복되면 루프를 멈추고 사람이 확인합니다. 루프는 반복을 대신할 수 있지만, 막힌 문제를 무한히 해결해 주지는 않습니다.랄프 루프는 개인 프로젝트 수준에서는 충분히 동작합니다. 다만 한 에이전트가 구현과 검증과 리뷰를 모두 맡으므로, 자신이 작성한 결과를 다른 관점에서 점검할 주체가 없습니다. 체크박스가 모두 채워졌다고 해서 완성도가 보장되지는 않습니다. 또한 BLOCKED 표시가 쌓이면 결국 사람이 개입해야 합니다. 막힌 항목을 풀어줄 판단 주체가 루프 안에 없기 때문입니다.이 한계를 줄이려면 두 가지가 필요합니다. 반복과 종료를 사람이 셸로 관리하지 않고 도구가 직접 처리하는 것, 그리고 작성하는 모델과 채점하는 모델을 분리하는 것입니다. 이 두 가지를 명령 하나로 제공하는 것이 /goal입니다.

[미친 활용 87] 숨겨진 오류, 참조 오류 빠르게 정리하기
📅 2026년 9월 20일 · 👁 34
[미친 활용 87] 숨겨진 오류, 참조 오류 빠르게 정리하기엑셀 업무를 하다가 자주 맞닥뜨리는 귀찮은 상황 중 하나는 데이터 중간중간 수식 오류가 포함되어 있는 경우가 아닐까 합니다. 데이터양이 많지 않을 때는 수식 하나씩 직접 검토하며 수정할 수 있지만, 양이 많다면 하나씩 찾아 수정하는 것은 엄청난 업무 부하로 이어집니다. 이렇게 대량 작업, 단순 반복 작업, 오류 수정 작업에 AI를 활용하면 시간을 대폭 절약할 수 있고, 직접 확인해서 수정하는 것보다 정확한 결괏값을 얻을 수 있습니다.01 오류가 포함되어 있는 셀 범위를 모두 선택합니다.02 ➊ 지정한 범위가 제대로 인식되었는지 확인 후 ➋ 오류 수정을 위한 프롬프트를 입력합니다.[나] : B2:F16 범위 값 중에서 수식 오류(#VALUE!, #REF!, #DIV/0!)에 대한 부분을 오류가 발생하지 않도록 수정해.03 이때 클로드가 파일 수정을 위한 권한을 요청하면 [Always allow] 또는 [Allow once]를 눌러 승인합니다.수정에 아주 민감한 파일이 아니라면 [Always allow]를 눌러 항상 허용을 설정하는 것이 편할 겁니다.04 그러면 다음과 같이 클로드가 분석한 내용과 변경할 내용을 알려줍니다.입력한 프롬프트에 따라 클로드가 지정된 범위의 오류 셀을 찾아 올바르게 수정하는지 확인해보세요.AI에게 명령어를 전달할 때, 범위를 정확히 명시하지 않으면 원하지 않는 범위까지 작업할 수 있습니다. 작업 대상 범위를 프롬프트에도 반드시 명시하여 명령어를 전달하는 것이 중요합니다.[AI 치트키] 수정 전 변경 내용 먼저 확인하고 싶다면?시트가 바로 수정되는 것을 원치 않는다면 프롬프트 마지막에 다음 문장을 추가하세요. AI가 값을 바로 바꾸지 않고 수정 대상과 변경 내용을 먼저 알려주기 때문에 작업 결과를 확인한 뒤 안전하게 수정할 수 있습니다.[나] : 기존 값을 수정하지 말고 수정할 값이 맞는지 내가 먼저 확인할 수 있게 알려줘.[미친 활용 88] 복잡한 수식, 빠르게 분석하기직장 선배가 갑자기 퇴사하여 인수인계받은 엑셀 파일에 이 파일이 어떤 의도로 만들어졌는지, 언제 사용하는지 설명 한 줄 없이 수식만 덩그러니 있다면 가슴이 철렁 내려앉을 겁니다. 엑셀을 잘하지도 못하는데 상사는 수식이 틀린 것 같다고 수정하라고 하는 상황이라면, 적혀 있는 수식의 동작 방식을 일일이 확인해가며 파악해야 합니다. 이때 AI를 통해 해당 시트의 수식을 분석해달라고 요청하면, 직접 수식에 대한 내용을 찾아가며 확인하지 않아도 아주 빠르게 정리된 결과를 받아볼 수 있습니다.01 수식 분석이 필요한 셀을 모두 선택합니다.02 ➊ 지정한 범위가 제대로 인식되었는지 확인 후 ➋ 수식 분석을 위한 프롬프트를 입력합니다.[나] : 선택한 셀 범위에 적용되어 있는 수식의 동작 원리를 설명해줘.03 입력한 프롬프트에 따라 클로드가 지정된 범위의 수식을 제대로 분석하는지 확인합니다.[AI 치트키] 수식 분석과 개선을 함께 요청해보세요수식의 동작 원리만 확인하는 데서 끝내지 않고 같은 결과를 더 효율적으로 구하는 수식까지 함께 요청할 수도 있습니다. 함수를 학습할 때, 응용이 필요할 때 활용하면 좋겠죠?[나] : C2:C4 범위에 적용된 수식의 동작 원리를 분석해 설명해주고, 해당 수식과 같은결괏값을 도출하되 조금 더 효율적인 수식을 E3 셀에 작성해줘.[미친 활용 89] 원하는 수식 빠르게 만들기회사 상사에게 일자별 판매 데이터가 적혀 있는 파일을 전달받으며 ‘월별, 상품별 판매 금액 총계 데이터를 뽑아줘.’라는 지시를 받았다고 가정해봅시다. 자료를 보니 SUMIFS 수식을 활용하면 구할 수 있을 것도 같은데, 막상 테스트해보니 생각한 결과가 나오지 않습니다. 어떤 형태로 데이터를 표현해야 할지, 어떤 수식을 써야 정확한 결과를 도출할 수 있을지 막막하다면 AI에게 내용만 전달해보세요. AI가 빠르고 깔끔하게 정리해줄 겁니다.01 일자별 판매 내역 데이터를 모두 선택합니다.02 지정한 범위가 제대로 인식되었는지 확인하고 결과 도출을 위한 프롬프트를 입력합니다.[나] : 선택한 범위의 데이터를 '월별/상품별 판매 금액 총액'을 계산하여 보여줄 수 있도록 하고 싶어. 가로에는 '품목', 세로에는 '월'을 표기하고 각 항목의 판매금액을 구하는 수식을 작성해줘.[AI] :03 요구사항에 따라 클로드가 작업한 결과가 정상적으로 동작하는지 확인합니다.[AI 치트키] 결과 표의 위치와 서식까지 지정하기수식으로 계산할 내용만 전달하면 결과는 맞더라도 표의 위치나 모양이 기대와 다를 수 있습니다. 결과를 시작할 셀, 행과 열에 배치할 항목, 셀의 색상 등 구체적인 정보를 함께 지정하면 바로 보고서에 활용하기 좋은 형태로 결과를 만들 수 있습니다.[나] : 선택한 범위의 데이터를 ‘월별/상품별 판매금액 총계’를 계산하여 보여줄 수 있게 하고 싶어.요구사항은 다음과 같아.F3 셀부터 가로에는 ‘품목’, 세로에는 ‘월’을 표시하고 각 항목의 판매금액을 구하는 수식을 작성행의 헤더 배경색은 ‘회색’, 글자 색상은 ‘검정색’으로 처리각 행/열의 합계를 표시하고, 셀 배경색은 ‘노란색’, 글자 색상은 ‘검은색’으로 처리작업 후 적용한 수식에 대한 동작 원리를 설명해줄 것[미친 활용 90] 데이터에서 원하는 값만 추출하기항목별로 정리되어 있지 않은 원본 데이터에서 이름, 연락처 등을 추출해야 할 때가 있습니다. 원본 데이터가 콜론(:), 쉼표(,) 등 특정한 구분 기호로 분리되어 있거나, 특정 규칙이 있다면 LEFT 함수와 LEN 함수와 MID 함수 등을 조합해서 추출하면 됩니다. 하지만 특정 규칙이나 구분 기호가 명확하게 분리되어 있지 않고 데이터의 순서도 규칙적이지 않다면, 데이터를 추출하기가 난감합니다. 이런 비정형 데이터를 가공하거나 추출할 때는, AI를 활용해 원하는 항목의 데이터만을 빠르게 추출할 수 있습니다.01 분석할 원본 데이터를 모두 선택합니다.02 지정한 범위가 제대로 인식되었는지 확인 후 결과 도출을 위한 프롬프트를 입력합니다.[나] : 선택한 범위에서 [이름, 직급, 회사명, 연락처, 주소]를 구분해서 D2셀부터 표 형태로 추출해주고, 정보가 없는 항목은 빈칸으로 처리해줘.[AI] :03 요구사항에 따라 클로드가 작업한 결과를 확인합니다.[AI 치트키] 예외 처리 기준까지 함께 전달하기비정형 데이터는 원하는 항목이 빠져 있거나 정해둔 항목에 넣기 애매한 내용이 섞여 있는 경우도 많습니다. 추출할 항목뿐만 아니라 빈 값 처리 방식, 형식 통일 기준, 남는 정보의 기록 위치까지 지정하면 결과를 다시 손보는 시간을 줄일 수 있습니다.[나] : 선택한 범위의 데이터에서 [이름, 직급, 회사명, 연락처, 주소]를 추출해야 하는데, 아래 요구사항을 준수할 것위 항목에 해당하지 않는 데이터는 [특이사항] 열에 별도로 기록할 것위 항목에 해당되는 데이터가 없다면 ‘공백’으로 처리연락처는 ‘010-1111-2222’ 형식으로 통일하여 표기 ④ 작업 결과는 D2 셀부터 표현[미친 활용 91] 원하는 피벗 테이블 빠르게 만들기일자별 판매 내역이 기록된 원본 데이터 테이블을 이용해 월별/지역별 판매 추이를 만들어야 합니다. 일반적으로 피벗 테이블을 활용하지만 피벗 테이블을 만들기 위해 행과 열, 값 영역 중 어디에 어떤 필드를 넣어야 원하는 데이터를 볼 수 있는지 한 번에 감이 오지 않습니다. 이때 AI의 도움을 받아보세요. 원하는 피벗 테이블을 쉽게 만들 수 있습니다.01 분석할 원본 데이터를 모두 선택합니다.02 ➊ 지정한 범위가 제대로 인식되었는지 확인 후 ➋ 결과 도출을 위한 프롬프트를 입력합니다.[나] : 선택한 범위의 데이터를 기반으로 '월별/지역별 판매 내역 추이'를 나타내는 피벗 테이블을 만들어줘.[AI] :04 요구사항에 따라 클로드가 작업한 결과를 확인합니다.[AI 치트키] 피벗 테이블 배치 기준을 구체적으로 정하기피벗 테이블은 같은 원본 데이터라도 행, 열, 값 영역에 어떤 필드를 배치하느냐에 따라 전혀 다른 결과가 만들어집니다. 그래서 배치 기준을 함께 알려주면 AI가 임의로 필드를 판단해 엉뚱한 형태의 피벗 테이블을 만드는 일을 줄일 수 있습니다. 또한 날짜 데이터가 텍스트로 입력되어 있거나 금액에 문자와 숫자가 섞여 있으면 그룹화나 합계가 제대로 되지 않을 수 있으므로 피벗 테이블을 만들기 전 원본 데이터의 날짜와 숫자 형식이 올바른지도 함께 확인해달라고 요청하면 더 안전한 결과물을 받을 수 있습니다.[나] :선택한 범위의 데이터에서 아래 요구사항을 만족하는 피벗 테이블을 생성해줄 것. 다음 요구사항을 따라줘.가로(행)은 날짜, 세로(열)은 지역을 배치할 것날짜는 월을 기준으로 그룹화하고, 월별/지역별 주문금액을 합산한 데이터가 보이도록 생성피벗 테이블은 새로운 시트를 생성하고, 생성된 시트의 A1 셀에 배치
[교사를 위한 캔바 05] 캔바 AI가 제안하는 교사 치트키
📅 2026년 9월 18일 · 👁 50
[교사를 위한 캔바 05] 캔바 AI가 제안하는 교사 치트키상상만 하던 수업 자료, 이제 AI가 현실로 만들어줍니다. 디자인 고민도 글쓰기 부담도 AI에게 맡겨보세요. 캔바의 매직 스튜디오(Magic Studio)와 다양한 AI 앱을 활용하면, 1시간 이상 걸리던 가정통신문 작성부터 이미지 생성, 음악 제작까지 단 몇 분 만에 완성할 수 있습니다. 단순 반복 업무는 획기적으로 줄이고, 수업의 창의성과 완성도는 한층 높여주는 교실 속 AI 활용 전략을 함께 익혀봅시다.Class 01 캔바 AI 2.0 활용하기 2026년 4월, 완전히 새롭게 업데이트된 캔바 AICanva AI 2.0은 이전보다 훨씬 강력하고 다양한 AI 기능을 제공합니다. 단순한 명령을 수행하는 수준을 넘어, 사용자의 작업 스타일을 기억하고 대화하듯 소통하며 원하는 결과물을 만들어내는 똑똑한 AI 비서로 진화했습니다. 디자인, 문서 작성, 데이터 분석, 코딩까지 하나의 공간에서 AI와 함께 처리할 수 있는 혁신적인 작업 환경을 경험해봅시다.Canva AI 2.0의 핵심 인터페이스와 주요 기능 살펴보기본격적인 Canva AI 2.0 학습에 홈페이지 내 [Canva AI] 탭과 작업 에디터를 통해 제공되는 Canva AI 2.0의 핵심 인터페이스와 주요 기능을 살펴보도록 하겠습니다.➊ 대화형 디자인 : 에디터 화면 툴바에서 [Canva AI에게 물어보기]를 누르면 AI와 채팅하듯 대화하며 디자인을 생성하거나 수정할 수 있습니다. 원하는 스타일, 색상, 레이아웃 등 구체적으로 설명하면 AI가 즉시 반영하여 디자인을 완성해줍니다.➋ 메모리 라이브러리(Memory Library) : 메모리 라이브러리는 내가 만든 디자인과 AI 사용 이력을 바탕으로 사용자의 취향과 작업 스타일을 기억합니다. 이를 기반으로 사용할수록 점점 더 본인에게 최적화된 맞춤형 결과를 추천해주죠. 메모리 라이브러리를 활성화하는 방법은 캔바 홈페이지 오른쪽 아래 [프로필]을 누르고 [ 설정]에서 [AI 맞춤 설정]를 누른 다음 기억 저장 및 참조를 토글을 체크하면 됩니다.또한 AI 맞춤 설정에 있는 [기록 관리➝]를 누르면 내 작업 성향을 학습하여 맞춤 기록한 About Me 문서를 생성합니다. 이 기능을 통해 AI가 분석한 개인별 맞춤 설정을 직접 검토하고 필요에 따라 수정·보완할 수도 있습니다.➌ Connectors(외부 앱 연동) : 슬랙Slack, 지메일Gmail, 노션Notion, 구글 드라이브Google Drive 등 다양한 외부 서비스를 캔바 AI와 연결할 수 있습니다. 메시지, 이메일, 노션 문서 등 연결된 앱의 데이터를 AI가 참고하여 디자인이나 문서를 더욱 정확하게 생성해주죠. Connectors를 연결하는 방법은 캔바 메인 화면 왼쪽 사이드바에서 [Canva AI]를 누른 후 검색창의 [+]을 선택하면 [앱 연결]이 보입니다. [앱 연결]을 눌러 연동할 앱을 선택한 뒤 [연결] 또는 [Connect]를 누르면 실행할 수 있습니다. 만약 앱을 최초로 실행하는 경우라면 계정 연동을 통해 앱 연결을 해야 합니다. 이럴 때는 [연결]을 눌러 캔바 접근 권한을 부여한 뒤 로그인합니다. 계정 연결이 완료된 후 토글 버튼을 켜서 활성화하면 프롬프트를 입력할 때 AI가 해당 앱의 데이터를 참고하여 더욱 정확한 결과를 만들어줍니다.한 가지 예로 구글 드라이브Google Drive를 연결하여 어떻게 작동하는지 자세히 살펴보겠습니다. [앱 연결]에서 [Google Drive]를 누릅니다. 그러면 연결하고 있다는 안내가 뜹니다. [연결]을 누르고 구글 계정을 선택하세요.그러면 Canva Drive Connector에서 Google 계정에 대한 액세스 요청 허용 팝업창이 나타납니다. 여기서 [계속]을 눌러 접근 권한을 허용해줍니다. 이후 다시 [Canva AI]를 눌러 코딩 화면으로 돌아온 뒤 [+] 버튼을 클릭해 앱 연결 목록을 살펴보면, 구글 드라이브가 정상적으로 연결된 것을 확인할 수 있습니다.➍ 브랜드 인텔리전스(Brand Intelligence) : 브랜드 인텔리전스는 캔바 AI에서 브랜드의 색상, 폰트, 레이아웃, 디자인 스타일을 AI가 자동으로 인식해 새로운 디자인에도 동일한 브랜드 아이덴티티를 유지하도록 도와주는 기능입니다. 브랜드 템플릿이나 브랜드 키트를 적용하면 캔바 AI가 브랜드 가이드에 맞춰 디자인을 생성해주기 때문에 일관성 있는 결과를 쉽게 얻을 수 있습니다. 캔바 메인 화면 왼쪽 사이드바에서 [Canva AI]를 선택하고 [+]를 누른 다음 [브랜드 적용]을 선택하세요. 그러면 캔바 AI가 어떻게 일관성 있는 디자인을 구현해내는지 다음 프롬프트를 직접 입력하며 확인해봅시다.[나] : 고등학생을 위한 ‘화학 결합’ 수업 포스터를 브랜드 키트에 맞춰 디자인해줘. 주요 개념을 한눈에 볼 수 있게 정리해주고, 브랜드 로고와 색상을 강조해줘.브랜드 인텔리전스를 활용하니, 브랜드 키트 색상을 사용하여 디자인의 일관성을 유지하면서도 주요 개념을 한눈에 파악할 수 있도록 잘 정돈된 포스터가 완성되었습니다.➎ 작업 예약 : 캔바 AI는 특정 작업을 예약하여 자동으로 실행할 수 있습니다. 원하는 시간에 자동으로 디자인 생성이나 요약 작업을 수행하도록 설정하여 업무 시간을 단축할 수 있죠. 캔바 홈 화면 왼쪽의 [Canva AI] 탭을 선택한 후, 프롬프트 입력창에 예약하고 싶은 작업 내용을 입력하세요. 그리고 입력창 옆의 [V]를 누르면 작업 예약이 보입니다. 여기에서 원하는 날짜와 시간, 반복 여부(매일/매주 등)를 설정하세요. 예약이 완료되면 예약 섹션에서 확인할 수 있습니다. 여기서는 다음 프롬프트를 입력하여 작업 예약을 설정하여 실행해보세요.[나] : 매주 월요일 오전 9시에 SNS 요약 보고서 만들어줘.예약 일정을 선택한 대로 예약 작업을 생성해주었습니다.➏ Canva Code 2.0 : 대화형 명령만으로 대시보드, 퀴즈, 계산기 등 인터랙티브한 웹페이지를 만들고, 바로 게시할 수 있는 기능입니다. 캔바 메인 화면에서 [Canva AI]를 선택한 후 [코드]를 눌러 원하는 디자인이나 기능을 설명하는 프롬프트를 입력하면 됩니다. 먼저 Canva Code 2.0의 주요 기능 몇 가지를 살펴봅시다.AI 프롬프트로 디자인 생성 : 원하는 기능이나 스타일을 설명하면 AI가 즉시 인터랙티브한 웹페이지나 요소를 만들어줍니다.실시간 미리보기 : 만든 디자인을 바로 실행(Play)하여 실제 동작을 확인할 수 있습니다.웹사이트로 게시 : 완성된 결과물을 웹사이트 형태로 즉시 공개할 수 있습니다.코드 복사 : 생성된 코드를 복사해 외부 프로젝트나 웹사이트에 활용할 수도 있습니다.만약 PART 04에서 실습했던 내용이 잘 기억나지 않는다면, 잠시 돌아가서 해당 기능을 다시 한 번 복습해보는 것을 추천합니다.➐ 웹 리서치 : 웹 리서치는 캔바 AI가 웹에서 최신 정보를 직접 찾아 디자인이나 문서 작업에 바로 활용할 수 있도록 요약 및 정리해줍니다. 캔바 메인 화면 왼쪽 사이드바에서 [Canva AI]를 선택한 후 프롬프트 입력창에 조사하고 싶은 주제나 내용을 입력하세요. 여기서는 다음과 같이 입력해보겠습니다.[나] : 2026년 대한민국 인공지능 트렌드를 조사해줘.캔바 AI가 관련 최신 정보를 검색한 뒤 핵심 내용을 요약해주며, 결과물을 다음과 같이 프레젠테이션이나 문서로 요청하여 작업에 바로 활용할 수 있습니다. 최신 통계, 뉴스, 트렌드 등을 빠르게 반영해야 할 때 매우 유용한 기능입니다.Canva AI 2.0 기능별 100% 활용법 알아보기Canva AI 2.0에서 제공하는 6가지 주요 기능의 특징과 실전 활용법을 알아봅시다. 캔바 메인 화면 왼쪽 사이드바에 있는 [Canva AI]를 누르세요. 입력창 아래로 다양한 버튼이 보일 겁니다. 이 기능을 하나씩 활용해보겠습니다.➊ 학생 활동 만들기 : 교육용 AI 특화 기능으로 교사와 학생이 수업에 활용할 수 있는 퀴즈, 워크시트, 토론 자료 등 활동 자료를 자동으로 만들어줍니다. 프롬프트에 다음과 같이 학생 활동의 주제 중 하나를 입력하여 자료를 생성해봅시다.[나] : 지구의 내부 구조 설명하기요청한 주제에 대한 학습 목표부터 인포그래픽, 스토리보드, 차트 등 다양한 자료를 생성해주었네요.[NOTE/] 학년과 과목을 설정하면 학생 활동을 생성할 수 있습니다. 다만 학습 목표에는 이해, 적용, 분석, 평가, 창작 등의 항목이 있어 함께 설정할 경우 오류가 발생하는 경우가 있습니다. 따라서 활동 주제를 구체적으로 입력하는 것이 가장 안정적이며, 학년·과목·학습 목표를 설정하지 않아도 잘 작동합니다.➋ 디자인 : 프레젠테이션, 포스터, 카드 등 원하는 디자인을 AI가 자동으로 만들어줍니다. 여기서는 다음 프롬프트를 입력해 학급 쿠폰을 만들어봅시다.[나] : 학급 쿠폰을 만들고 싶어. 귀엽고 컬러풀한 디자인에 템플릿을 만들어줘.학급에서 활용할 수 있도록 다양한 색상의 쿠폰을 만들어주었습니다. 뿐만 아니라 만들어진 디자인은 에디터 툴바에서 바로 수정과 활용할 수 있습니다.➌ 이미지 : 텍스트 프롬프트와 AI 품질, 가로세로 비율과 스타일을 설정하면 AI가 이미지를 생성해줍니다. 여기서는 다음과 같이 프롬프트를 입력해봅시다.[나] : 푸른 하늘과 구름이 있는 평화로운 풍경 그려줘.입력한 내용에 맞는 이미지를 여러 개 제안하며, 원하는 이미지를 디자인에 바로 삽입할 수 있습니다.➍ Docs : AI가 보고서, 에세이, 요약문, 안내문 등 다양한 문서를 자동으로 작성합니다. 예를 들어 다음 프롬프트를 입력해봅시다.[나] : 초등학생을 위한 환경 보호 안내문을 친근하고 쉽게 작성해줘.관련된 문서 초안을 빠르게 생성할 수 있으며, 생성된 문서는 에디터 기능을 통해 자유롭게 수정할 수 있습니다.➎ 코드 : AI가 퀴즈부터 대화형 웹페이지, 계산기, 출석부 등 인터랙티브한 콘텐츠를 코드 형태로 만들어줍니다. 다음 프롬프트를 입력하여 어떻게 만들어주는지 확인해봅시다.[나] : 학생 출석 체크 리스트 만들기요청만으로 바로 사용할 수 있는 인터랙티브 요소가 생성되며, 디자인에 삽입하거나 별도의 웹사이트로 게시할 수도 있습니다. 기억나지 않는다면 PART 04 캔바 코드 부분으로 돌아가 실습과 함께 활용해보세요.➏ 동영상 클립 : 원하는 장면과 분위기, 스타일 등을 텍스트로 설명하면 AI가 6~8초 길이의 고품질 동영상 클립을 만들어줍니다. 이때 프롬프트는 영상의 주제, 구체적인 행동, 배경 분위기, 카메라 앵글 및 스타일 등을 상세하게 입력할수록 상상했던 이미지에 가장 가까운 영상을 얻을 수 있습니다. 여기서는 다음 프롬프트를 입력해 짧은 영상 클립을 만들어봅시다.[나] : 맑은 하늘 아래 꽃밭에서 뛰노는 아이들, 밝고 따뜻한 분위기, 부드러운 카메라 이동직접 촬영하지 않아도 프롬프트만 잘 입력하면 다음과 같이 프레젠테이션이나 영상 제작에 활용할 수 있는 고품질 영상 소스를 손쉽게 만들 수 있습니다. 단, 음성 및 배경음악 포함 여부에 따라 영상 길이는 달라질 수 있습니다.Canva 2.0 AI 사용량에도 한도가 있어요Canva AI 2.0이 적용된 교육용 계정도 이미지 생성, 영상 생성 등 AI 기능을 사용할 때 월별 AI 사용량 한도가 적용됩니다. 이 사용량은 팀 전체가 공유하며, 한도를 초과하면 다음 갱신일까지 추가 사용이 제한됩니다. 현재 교육용 계정에서는 별도의 AI 사용량 추가 구매 옵션이 제공되지 않습니다.다만 Canva Education(교사용) 계정의 경우 월간 사용량 한도를 초과하더라도 표준·프리미엄·울트라 AI 기능을 계속 사용할 수 있으며, 각 작업 사이에 짧은 대기 시간이 발생합니다. 또한 구독 갱신일이 되면 사용량이 초기화되어 다시 정상적으로 이용할 수 있습니다. 다음은 교육용 계정에서 AI 사용량 한도에 포함되지 않는 기능입니다.Magic Write : 텍스트 생성, 요약, 문장 다듬기, 톤 변경 등이 있어요. 공정 사용 정책은 적용되지만 AI 사용량에는 포함되지 않습니다.사진 및 동영상 애니메이션 : 이미지나 동영상에 애니메이션 효과를 적용할 때 사용됩니다.AI Voice : 텍스트를 음성으로 변환하는 기능입니다.반면 이미지, 영상, 디자인 생성 등 다음과 같은 기능에 프리미엄·울트라 AI 도구를 사용할 경우 사용량이 차감됩니다. 특히 단순 텍스트나 디자인 편집에 비해 영상 및 이미지 생성은 한 번에 더 많은 사용량을 차감하므로, 수업 중에 여러 번 반복해서 활용하면 한도에 빠르게 도달할 수 있으니 주의하기 바랍니다.매직 미디어에서 이미지, 그래픽, 비디오를 생성하는 것캔바 코드로 인터랙티브 디자인을 생성하거나, 다른 디자인에 코드 요소(퀴즈, 계산기 등)를 추가하는 것매직 레이어는 이미지의 각 요소를 분리해 개별적으로 편집하는 것에디터 화면에서 [캔바 AI에게 물어보기]를 통해 색상 변경, 스타일 변경, 요소 추가 등 디자인을 바꾸는 기능을 사용하는 것

[아티클 01] AI 에이전트 엔지니어링에서 컨텍스트 오염 유형
📅 2026년 9월 16일 · 👁 75
[아티클 01] 컨텍스트 오염 유형에이전트와 오랫동안 대화하다 보면 이상한 현상을 겪게 됩니다. 처음에는 정확하게 코드를 작성하던 에이전트가 갑자기 엉뚱한 파일을 수정하거나, 이미 해결된 문제를 다시 고치려 하거나, 응답 품질이 눈에 띄게 떨어집니다. 이런 현상의 원인은 여러 가지이며, 그중 하나는 컨텍스트 자체에 문제가 생긴 경우입니다.이런 증상의 원인은 여러 가지이며, 그중 한 가지는 컨텍스트 자체에 문제가 생기는 경우입니다. 컨텍스트 윈도우에 불필요하거나 잘못된 정보가 쌓여 모델의 성능이 저하되는 현상을 컨텍스트 오염(Context Pollution)이라고 부릅니다. 에이전트가 오래 작업할수록, 이전의 실패한 시도, 잘못된 경로, 긴 에러 메시지, 이미 수정된 코드 등이 컨텍스트에 남아 모델을 혼란스럽게 만듭니다.작업 초반에는 컨텍스트에 현재 작업에 필요한 정보만 들어 있습니다. 그러나 세션이 길어지면 지난 시도, 이미 해결된 오류, 작업과 무관한 파일 내용이 함께 쌓여, 모델이 정작 필요한 정보를 가려내기 어려워집니다. 이때는 컨텍스트를 정리하고 다시 시작하는 편이 가장 빠른 해결책입니다. 컨텍스트 오염은 원인에 따라 네 가지로 분류할 수 있습니다.유형 1 : 히스토리 오염대화가 길어지면서 이전의 잘못된 시도나 에러가 컨텍스트에 남아 있는 경우입니다. 에이전트가 이전에 실패한 접근법을 반복하거나, 이미 수정된 에러에 다시 대응하려 합니다.이전 대화에서 발생했던 에러 메시지가 컨텍스트에 남아 있어서, 에이전트가 현재 상태가 아닌 과거 상태를 기준으로 판단하는 것입니다.유형 2 : 파일 오염관련 없는 파일을 너무 많이 읽어서 컨텍스트가 불필요한 정보로 가득 찬 경우입니다. 에이전트가 작업과 무관한 파일을 수십 개 읽으면, 정작 중요한 파일의 내용이 Lost in the Middle 현상으로 묻히게 됩니다.유형 3 : 지시 충돌상충하는 지시가 컨텍스트에 공존하는 경우입니다.컨텍스트에 “JavaScript로”와 “TypeScript로” 두 지시가 모두 남아 있어서 에이전트가 일관성을 잃게 됩니다.유형 4 : 도구 출력 오염도구 실행 결과, 특히 긴 에러 로그나 빌드 출력이 컨텍스트를 대량으로 소비하는 경우입니다. 에이전트가 npm install을 실행했는데 수백 줄의 경고 메시지가 출력되면, 그 모든 텍스트가 컨텍스트에 들어갑니다. MCP 도구의 대량 출력도 같은 문제를 일으킵니다.여러분이 에이전트를 사용하면서 다음과 같은 징후가 나타나면 컨텍스트 오염을 의심해봅시다.에이전트가 이전에 해결된 문제를 다시 언급한다같은 실수를 반복한다 (같은 에러 → 같은 잘못된 수정 → 같은 에러)응답이 느려지거나 품질이 갑자기 저하된다“앞서 말씀하신 X에 대해”라며 실제로 말한 적 없는 내용을 참조한다관련 없는 파일이나 코드를 갑자기 수정하려 한다에이전트의 응답이 점점 길어지고 초점을 잃는다이런 징후가 보이면, 더 길게 끌기보다 바로 정리하는 편이 전체 작업 시간을 오히려 줄여줍니다.

[AICE ASSOCIATE] 이진분류 DNN
📅 2026년 9월 15일 · 👁 76
이진 분류 DNN, 출력층과 손실함수 짝 맞추기 "코드는 따라 쳤는데, 왜 여기에 sigmoid를 쓰는지는 모르겠어요."딥러닝 파트에 들어오면 이 상태가 되는 경우가 많다. Dense(1, activation='sigmoid'), loss='binary_crossentropy' 같은 코드를 외워서 쓰고 있지만, 문제가 조금만 바뀌면 손이 멈춘다. 다중 분류로 바뀌면? 회귀로 바뀌면? y가 원핫으로 되어 있으면?문제는 이걸 세 가지 따로따로 외우려 한다는 점이다. 출력층 뉴런 개수, 활성화 함수, 손실 함수를 각각 암기 항목으로 두면 조합이 아홉 가지가 넘는다. 헷갈리는 게 당연하다.그런데 실제로는 외울 게 하나뿐이다. 문제 유형이 정해지면 나머지 셋은 자동으로 따라온다. 그 연결 고리를 이해하면 조합표를 외울 필요가 없어진다. 이 글에서 그 고리를 만든다.1. 출력층은 '정답의 모양'을 그대로 닮아야 한다 신경망의 마지막 층은 예측값을 내보내는 곳이다. 그래서 출력층의 모양은 우리가 원하는 정답의 모양과 같아야 한다. 이 문장 하나가 이 글의 전부다.비유를 하나 쓰자. 택배를 보낼 때 상자를 고르는 상황과 같다. 책 한 권을 보내면 작은 상자, 냉장고를 보내면 큰 상자다. 내용물이 상자 크기를 정하지, 상자를 먼저 고르고 내용물을 맞추지 않는다. 출력층도 마찬가지다. 예측하려는 값이 어떤 형태인지가 출력층의 뉴런 개수와 활성화 함수를 정한다.정확한 용어로 다시 정리하면 이렇다. 이진 분류의 정답은 0 또는 1이라는 하나의 값이다. 그러니 뉴런은 1개면 된다. 다중 분류의 정답은 여러 클래스 중 하나인데, 모델은 각 클래스일 확률을 모두 내놓아야 하므로 클래스 개수만큼의 뉴런이 필요하다. 회귀의 정답은 하나의 실숫값이므로 뉴런은 1개다.여기서 이진 분류와 회귀가 둘 다 뉴런 1개라는 점을 눈여겨보자. 둘을 가르는 건 뉴런 개수가 아니라 활성화 함수다.표를 통째로 외우려 하지 말고 첫 열에서 시작해 오른쪽으로 읽는 연습을 하자. '이진 분류다, 정답이 0 아니면 1이다, 그러니 뉴런 1개, 0과 1 사이 값을 내려면 sigmoid, 그 짝은 binary_crossentropy.' 이 흐름으로 도달하는 게 목표다.시험에 자주 나오는 함정 이진 분류 문제이므로 출력층의 뉴런 수는 클래스 개수인 2로 설정한다.틀렸다. 이 선지가 매력적인 이유는 논리가 그럴듯하기 때문이다. 클래스가 두 개니까 뉴런도 두 개일 것 같다. 그런데 이진 분류에서는 양성 클래스일 확률 하나만 알면 나머지는 자동으로 정해진다. 양성일 확률이 0.87이면 음성일 확률은 0.13이다. 굳이 두 개를 계산할 이유가 없다.뉴런 2개에 softmax를 쓰는 방식이 완전히 불가능한 건 아니다. 그렇게 구성해도 학습은 된다. 다만 그때는 손실 함수도 categorical_crossentropy 계열로 바꾸고 y도 원핫으로 만들어야 한다. AICE ASSOCIATE에서 요구하는 표준 형태는 뉴런 1개에 sigmoid다.2. sigmoid가 하는 일, softmax가 하는 일 활성화 함수를 '비선형성을 주는 장치'라고만 배우면 출력층에서 왜 이걸 쓰는지 감이 안 온다. 출력층의 활성화 함수는 역할이 다르다. 은닉층에서는 표현력을 키우는 게 목적이고, 출력층에서는 값의 범위를 정답의 범위에 맞추는 게 목적이다.sigmoid는 어떤 실숫값이 들어와도 0과 1 사이로 눌러 준다. 아주 큰 음수가 들어오면 0에 가까워지고, 아주 큰 양수가 들어오면 1에 가까워진다. 실제로 확인해 보면 이렇다.입력이 0일 때 정확히 0.5가 나온다는 점도 기억해 두자. 그래서 예측 클래스를 정할 때 0.5를 기준으로 삼는 게 자연스럽다.softmax는 여러 값을 한꺼번에 받아 전체 합이 1이 되는 확률 분포로 바꾼다.여기가 sigmoid와 결정적으로 다른 지점이다. sigmoid는 각 뉴런을 독립적으로 0과 1 사이로 누른다. 여러 뉴런에 sigmoid를 걸면 각각 0.9, 0.8, 0.7이 나올 수 있고 합이 1을 넘는다. softmax는 뉴런들끼리 경쟁시켜 합을 1로 만든다. '이 셋 중 하나'라는 다중 분류의 성격과 정확히 맞아떨어진다.이제 잘못 골랐을 때 무슨 일이 생기는지 보자.가장 흔한 실수는 은닉층에 쓰던 relu를 출력층에도 그대로 두는 것이다. relu는 음수를 0으로 만들고 양수는 그대로 통과시킨다. 출력 범위가 0 이상 무제한이라 1을 넘는 값이 나온다. 확률로 읽을 수 없다.활성화 함수를 아예 빼는 것도 문제다. 같은 데이터로 실제 학습시켜 출력값을 뽑아 보면 차이가 분명하다.활성화를 생략하면 음수가 그대로 나온다. 확률이 음수일 수는 없다. 다만 이건 회귀 출력층에서는 정상이다. 집값이나 수요량을 예측할 때는 값을 그대로 내보내야 하므로 활성화 함수를 지정하지 않는 게 맞다.은닉층에 relu를 쓰는 이유도 한 번 짚고 가자. sigmoid를 은닉층에 깊게 쌓으면 역전파 과정에서 기울기가 계속 작아져 앞쪽 층까지 전달되지 않는다. 이걸 기울기 소실(vanishing gradient)이라고 한다. relu는 양수 구간에서 기울기가 1로 유지되기 때문에 이 문제가 덜하다. 그래서 은닉층은 relu, 출력층은 문제 유형에 맞는 함수라는 구도가 표준이 됐다.시험에 자주 나오는 함정 softmax는 각 클래스의 확률을 독립적으로 계산하므로 출력값의 합이 1을 넘을 수 있다.틀렸다. 독립적으로 계산하는 건 sigmoid다. softmax는 모든 출력을 지수 변환한 뒤 그 합으로 나누기 때문에 합이 반드시 1이 된다. 이 선지가 매력적인 이유는 '확률'이라는 단어에서 독립을 연상하기 때문이다. 하지만 softmax의 목적 자체가 상호 배타적인 클래스 중 하나를 고르는 것이라, 합이 1이어야 의미가 있다.참고로 한 샘플이 여러 클래스에 동시에 속할 수 있는 다중 레이블 문제에서는 오히려 sigmoid를 여러 뉴런에 걸어 쓴다. 다만 AICE ASSOCIATE 범위는 아니다.3. 코드로 조립하기, 그리고 짝이 안 맞을 때 이제 실제 코드를 보자. 이진 분류 DNN의 표준 뼈대는 이렇다.Input(shape=(10,))의 10은 특성 개수다. 여기서 실수가 자주 난다. 원본 데이터의 컬럼 수가 아니라 인코딩과 전처리를 모두 마친 뒤의 컬럼 수를 넣어야 한다. 범주형 변수를 원핫으로 펼쳤다면 컬럼이 늘어나 있을 것이다. X_train.shape[1]을 그대로 넣는 습관이 안전하다.쉼표를 빼먹으면 안 된다. (10)은 그냥 정수 10이고 (10,)이 원소 하나짜리 튜플이다. 파이썬 문법이지만 시험에서 코드 채우기 문제로 나오면 눈에 띄지 않는다.모델을 만든 뒤 model.summary()로 구조를 확인하는 습관도 권한다. 위 모델의 출력은 이렇다.파라미터 개수 계산도 시험에 나온다. 공식은 입력 뉴런 수 곱하기 출력 뉴런 수, 더하기 출력 뉴런 수다. 마지막에 더하는 건 편향(bias)이다. 첫 층은 10 곱하기 32 더하기 32로 352, 둘째 층은 32 곱하기 16 더하기 16으로 528, 출력층은 16 곱하기 1 더하기 1로 17이다. 합이 897로 맞아떨어진다.학습과 예측은 이렇게 이어진다.predict()가 확률을 반환한다는 점이 중요하다. 정확도나 F1 점수를 계산하려면 클래스로 바꿔야 하는데, 여기서 0.5 기준 변환을 빼먹는 실수가 잦다. 확률값을 그대로 정확도 함수에 넣으면 값이 이상하게 나오거나 에러가 뜬다.손실 함수와 y 형태가 어긋나면 다중 분류에서 가장 자주 터지는 지점이다. categorical_crossentropy는 y가 원핫 벡터일 것을 기대하고, sparse_categorical_crossentropy는 y가 정수일 것을 기대한다. 짝이 안 맞으면 학습이 시작되지 않는다.에러 메시지가 친절한 편이다. target의 shape가 1차원인데 output은 3차원 열을 갖고 있다고 알려 준다. y를 원핫으로 바꾸면 해결된다.정리하면 선택지는 두 개다. y를 원핫으로 바꾸고 categorical_crossentropy를 쓰거나, y를 정수 그대로 두고 sparse_categorical_crossentropy를 쓰거나. 후자가 변환 단계가 하나 줄어서 실기에서는 더 편하다. 이름에 붙은 sparse가 '희소하게 표현된', 즉 정수 하나로 압축된 형태를 뜻한다고 기억하면 헷갈리지 않는다.시험에 자주 나오는 함정 model.predict()는 예측된 클래스 레이블을 반환하므로 정확도 계산에 바로 사용할 수 있다.틀렸다. 케라스의 predict()는 출력층을 통과한 값을 그대로 반환한다. 이진 분류라면 sigmoid를 지난 확률값이고, 다중 분류라면 softmax를 지난 확률 분포다. 클래스 레이블이 아니다. 이진 분류는 0.5 기준으로 변환하고, 다중 분류는 np.argmax(pred, axis=1)로 가장 확률이 높은 인덱스를 뽑아야 한다.이 선지가 매력적인 이유는 사이킷런의 습관 때문이다. 사이킷런 모델의 predict()는 실제로 클래스를 반환하고, 확률이 필요하면 predict_proba()를 따로 부른다. 케라스는 반대다. 두 라이브러리를 오가며 쓰다 보면 이 차이에서 걸린다.시험 직전에 이것만 이진이면 1개에 sigmoidsparse는 y가 정수라는 뜻predict는 확률, 0.5로 잘라야 클래스『빠르게 따는 AICE ASSOCIATE』에서는 어디를 보면 되나 이 글의 내용은 책 PART 5 AI 모델링 딥러닝에 집중돼 있다. 활성화 함수의 개념과 신경망 설계는 01장 인공신경망(164쪽)의 01절부터 03절 '인공신경망 설계'(172쪽)까지고, 학습 메커니즘인 순전파와 역전파는 02절 '인공신경망의 학습 메커니즘'(169쪽)에 있다. 은닉층에 relu를 쓰는 이유를 제대로 이해하려면 이 02절을 한 번 읽어야 한다.실제 코드 조립은 03장 딥러닝 실전 모델링이다. 01절 '이진 분류 DNN'(193쪽), 02절 '다중 분류 DNN'(197쪽), 03절 '회귀 DNN'(200쪽)이 나란히 배치돼 있다. 이 배치가 학습에 유리하다. 세 절을 이어서 읽으면 이 글의 표가 자연스럽게 머리에 들어온다. 하나만 떼어 읽으면 비교가 안 되니 세 절은 붙여서 보길 권한다.시험 직전 압축 정리는 PART 6 빈출 패턴 분석의 03장 AI 모델링이다. 03절 '딥러닝 모델 설계 및 학습'(247쪽)과 04절 '딥러닝 모델 성능 평가 및 저장'(250쪽)에서 실기 형태로 다시 정리된다. 이 글에서 다룬 predict() 반환값 처리 같은 건 04절 쪽에 붙어 있는 내용이다.딥러닝 파트는 눈으로 읽어서는 절대 안 붙는다. Dense(1, activation='sigmoid')를 손으로 열 번 쳐 보는 게 설명을 열 번 읽는 것보다 낫다.🖥️ 골든래빗 CBT에서 AICE ASSOCIATE 문제 풀어보기📅 2026 AICE ASSOCIATE 시험 일정 확인하기📘 『빠르게 따는 AICE ASSOCIATE』 자세히 보기궁금한 게 생기면 『빠따 AICE ASSOCIATE』 공식 카카오톡 질문방에서 물어보세요. 저자들이 직접 답합니다.

[make 03] 클로드에 메이크 MCP 연결하기
📅 2026년 9월 14일 · 👁 97
클로드 데스크톱 앱에 Make MCP 연결하기먼저 다음 페이지에 접속해 클로드 데스크톱 앱을 다운로드해 설치하세요.클로드 데스크톱 앱 다운로드 : claude.com/download 원활한 사용을 위해 Pro 이상의 요금제 구독을 권장합니다. 클로드 데스크톱 앱에서 메이크 시나리오를 불러 쓰려면, 먼저 메이크를 클로드에 커넥터로 등록해야 합니다.클로드 데스크톱 앱에 커넥터 추가하기01 클로드 데스크톱 앱을 실행합니다. 프롬프트 입력창에서 [+ → 커넥터 → + connector 추가 → 커넥터 둘러보기]를 클릭하세요. ‘connector’는 ‘MCP 서버’의 다른 표현입니다. 즉, ‘쉽게 연결할 수 있는 클로드용 MCP서버 = 커넥터’라고 생각하면 됩니다. 02 검색란에서 ‘make’를 입력한 다음, [Make] 옆의 [+] 버튼을 누릅니다.03 액세스 권한 부여 화면이 뜨면서 브라우저창이 열립니다. 다음과 같이 전체 권한을 체크한 다음, [Allow]를 눌러 권한을 승인하세요. 현재는 정상 작동 여부를 확인하기 위해 체크박스 전체를 체크해 진행하지만, 실무에 사용할 때는 보안을 위해 꼭 필요한 권한만 체크해 진행하는 것을 권장합니다. 04 “You’re all set!” 알림이 뜨며 “Claude을(를) 여시겠습니까?”라는 알림창이 뜹니다. [Claude 열기]를 클릭합니다.05 클로드 데스크톱 앱으로 이동하고 오른쪽 위에 “Make와 연결되었습니다”라는 팝업이 뜹니다.06 클로드 데스크톱 앱을 완전히 종료했다가 다시 켭니다. 프롬프트 입력창에서 [+ → 커넥터]로 들어가 보면 Make가 정상적으로 연결된 것을 볼 수 있습니다.